POINT01
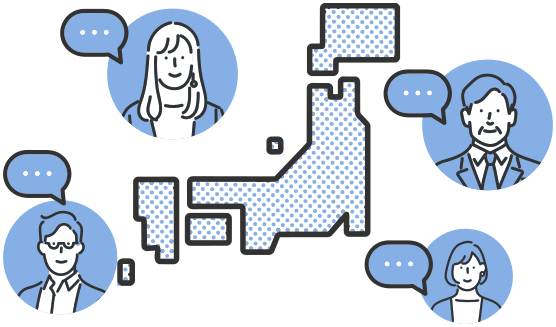
多様な話者属性
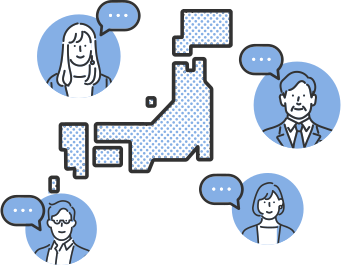
全国の20代〜70代、男女、全都道府県、多様な職業・世帯年収を網羅。
日本の生成AI開発力を解き放つ。
国内最大級・権利処理済み
参加者3万人超・7万コール超の音声・映像・アノテーション済みテキストを収録。
話者属性や感情タグを備え、AIモデルの学習・評価に活用可能。
お気軽にお問い合わせください!
データセットお問い合わせ・お申し込み SCROLL
モニター
 30,000人超
会話数
 7,000,000超
 商用利用可
全国の20代〜70代、男女、全都道府県、多様な職業・世帯年収を網羅。
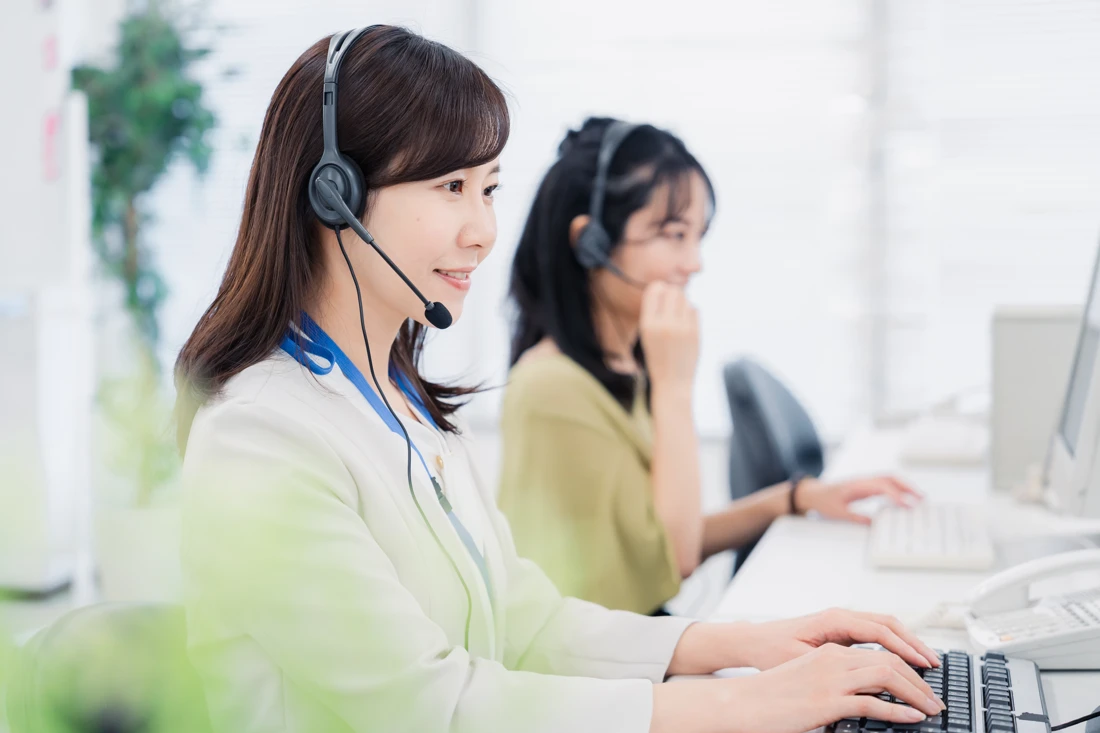
アパレル・保険・自治体など10種のコールセンター業務+約800種類の日常雑談テーマ。
話者分離済み⾳声‧上半⾝動画‧整形テキストに加え、フィラー(⾔い淀み)、相槌、会話ターンごとの5段階感情タグを付与。
データ提供者から、AI学習・商用利用を目的とした第三者提供に関する同意を取得済み。
「相槌のない不自然に長い発話」を解消し、短い発話を重ねるスムーズなテンポを獲得。
※1
性別推定
既存モデル 34.5 → 訓練後モデル 99.4
年代推定
既存モデル 45.5 → 訓練後モデル 86.9
※1
東京科学大学、名古屋大学、SB Intuitions等の研究・開発現場で高い有用性を確認。
※1:出典:DiaFill: 短い発話でフィラーが豊富な音声対話台本の自動生成ツールキット, 言語処理学会 第32回年次大会

利用用途やご相談内容を、お問い合わせフォームよりお送りください。

ご要望・対象領域・必要なデータ条件をヒアリングし、最適な活用方法をご提案します。

利用目的や利用範囲に応じて、データの加工などの準備を致します。

契約内容に基づき、対象のデータセットを安全な方法でご提供します。
お客様のご要望やご利用状況をお伺いしたうえで、最適な料金プランをご案内いたします。
お気軽にお問い合わせください!
データセットお問い合わせ・お申し込み